当我们谈论 AI 多模态的落地时,往往最先关注图像、视频这些视觉领域的突破,却容易忽略声音 —— 这个内容生态里不可或缺,却长期被生产效率制约的赛道。在 6 月 23 日火山引擎 FORCE 原动力大会上,豆包音频生成模型 1.0 的正式发布,补上了多模态内容生产的重要一块,也让我们看到了声音创作回归创意本身的可能。
当前 AI 正大规模进入企业生产流程,模型调用量呈爆发式增长。官方数据显示,截至 2026 年 6 月,豆包大模型日均 Token 调用量已突破 180 万亿,过去一年增长超 10 倍;在中国公有云 MaaS 服务市场,火山引擎以 49.5% 的份额位居第一,超 200 家企业年度累计 Token 使用量超 1 万亿。在这样的产业背景下,音频作为内容生产的核心载体,其生产效率的提升,早已不只是创作者的个人需求,更是整个内容产业降本提效的关键命题。
长期以来,音频生产都困在 “碎片化流程” 里:对白、音效、配乐分属不同环节,需要不同岗位的人协作,再通过后期剪辑合成,周期长、成本高,也限制了创意的快速落地。而豆包音频生成模型 1.0 最核心的价值,就是把这套碎片化的流程彻底重构,用一条 Prompt 完成全链路生产。它不只是提升了 “配音” 的效率,而是重新定义了音频创作的工作流 —— 创作者不再需要把精力花在素材拼接、轨道对齐这些技术环节,只需要专注于内容表达本身。
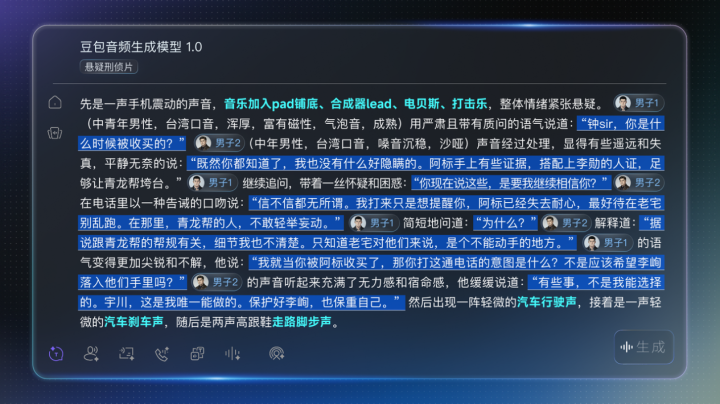
在具体能力上,这款模型的三个特点尤其值得关注。其一,是全要素一体化生成能力。单条指令即可同时编排多角色对白、情绪语气、方言口音,以及背景音乐、环境音效,输出即为具备完整叙事感的成片。那些笑声、停顿、叹息之类的细节,过去需要配音演员反复打磨,现在通过文字描述就能精准还原,让声音内容的生命力不再依赖人工录制的反复调试。
其二,是长时音色的一致性保障。长音频创作的核心痛点从来不是单句质量,而是跨段落的音色统一。有声书、长剧集动辄几十上百集,一旦音色漂移,整个作品的沉浸感就会被打破。这款模型通过文生音频与参考音频的深度联动,实现了多次延长生成中的音色高度稳定,让创作者不用再把大量时间消耗在后期修音和音色校准上。
其三,是 0 样本创作的灵活性。无需额外训练,仅凭文本描述就能生成匹配的音色,还能实现音色与风格的解耦控制,同一音色适配不同情绪场景,甚至支持 “一声多角” 的差异化表达。这意味着中小团队甚至个人创作者,不用搭建专业录音棚、不用签约多名配音演员,就能产出角色丰富、质感统一的音频内容。
更值得关注的是,这款音频模型并非孤立的产品,而是火山引擎多模态生成矩阵的一环。它可以和 Seedream 图像模型、Seedance 视频模型形成协同,比如先由图像模型生成科普素材,再由视频模型串联成片,最后由音频模型完成解说与配乐,实现全链路多模态内容的自动化生产。
从文字到图像,从视频到音频,AI 正在一步步把内容生产的各个环节从 “专业技能” 变成 “通用工具”。而真正的技术普惠,从来不是把复杂的参数堆给用户,而是把复杂的技术藏在背后,让每个人都能专注于创意与表达。豆包音频生成模型 1.0 的意义,或许正在于此 —— 它让声音创作不再有技术门槛,只留下创意的边界。
#火山引擎 FORCE 原动力大会#火山引擎